
肝心なことを黙っていました: Fellowi Videoは4K・30秒・音付きに対応しています
著者: Fellowiチーム · · 6 分で読めます
少し気まずい記事です。私たちがFellowi Videoについて出してきた記事はどれも同じことを書いています。アップロードした画像からつくる、720pの4秒クリップ。公開当時はその通りでした。もうしばらく前からそうではなく、誰も戻って古い記事を書き直さなかったせいで、自社のブログが自社の読者に対して製品を過小に伝えてきました。
というわけで、切り上げなしの現状の一覧です。
モデルは1つではなく4つ
系統はふたつ。turboは速くて安い。フルは遅く、鋭く、かなり高い。それぞれに画像からのモデルとテキストからのモデルがあります。
テキストからのモデルは一文を受け取って、誰が写っているかも含めて場面ごと発明します。画像からのモデルはすでにある静止画を動かします。特定のキャラクターなら後者がほぼ常に正解です。静止画が顔の問題を片づけているので、動画モデルは動きだけを解けばよいからです。誰が写るかにこだわらないなら、テキストは一手省けます。この選択は キャラクターの一枚をクリップに変える記事で詳しく扱っています。
解像度と、秒あたりの料金
秒単位で課金され、料金はモデルと解像度で決まります。パッケージへの切り上げはありません。
- turbo: 720pで毎秒125コイン、1080pで150。
- フル: 480pで115、720pで225、1080pで550、4Kで1100。
実際のところ、720pの4秒turboクリップは500コイン。これはいちばん小さいコインパックの値段、およそ2ユーロです。1080pの10秒turboなら1500。フルモデルの4K 4秒は4400で、正直に言えば4Kは探索の道具ではなく仕上げの一手です。まず720pでカットを見つけてください。この算数は 1枚あたり実際にいくら払うのかという記事と同じ理屈です。
最長30秒
4秒の上限はなくなりました。4秒から30秒まで、好きな長さを選べます。長ければよいわけではありません。モデルには崩れる時間が余分に与えられ、18秒目でおかしくなる30秒のクリップは、崩れない4秒より高くつく失敗です。まともな進め方は、アイデアを4秒だけ買い、持ちこたえるか判断し、そのあとで長い版を買うことです。
縦を含む7つの画角
アスペクト比は自動のままにでき、そうすると開始画像の構図が保たれます。この既定値は聞こえる以上に重要です。縦の静止画を無理に16:9へ入れると切られるか余白が付き、この選択肢ができる前はまさにそうなっていました。明示的な選択肢は16:9、9:16、3:4、4:3、1:1、21:9です。
多くの人が本当に探しているのは9:16で、その用途は Reels向けの縦クリップの記事に分けて書きました。
ほとんど知られていない終了フレーム
これは公の場で一度も触れたことのない機能です。開始画像に加えて終了画像を渡すことができ、モデルは一方からもう一方へたどり着く動きを組み立てます。
道具の用途が変わります。これがなければ、動きを書いて祈るだけです。あれば、すでに承認した2枚の絵のあいだの移行を演出していることになります。同じキャラクターの別のポーズを2枚生成して両方渡せば、当てずっぽうではなくひとつながりのカットが返ってきます。 キャラクターの見た目を揃える方法と自然に噛み合います。2枚がカットの両端を固定するからです。
音
クリップには場面に合わせて生成されたサウンドトラックを付けられます。追加料金はなく、オフにもできます。思っているよりオフが正解の場面は多いです。音楽や自前の音を上に乗せるつもりなら、生成された音はあとで剥がす対象でしかありません。
変わっていないこと
大人同士の大人向け表現は許可されていて、恒久的な二つの拒否も同じです。未成年が関わる性的な表現と、同意のない描写。失敗したレンダリングは全額自動で返金され、だからこそ4秒で試すのが理にかなった進め方になります。
あなたの中のFellowi Videoが720pの4秒クリップのままなら、それは古く、私たちの落ち度です。Videoタブを開いて設定を見てください。出発点になる静止画が要るなら、先に1枚つくりましょう。
この記事で答えている質問
Fellowi Videoのクリップはどれくらいの長さにできますか?
4秒から30秒までです。長さを秒単位で選び、秒あたりで課金されるので、6秒のクリップは10秒より安くなります。固定プランへの切り上げはありません。
Fellowi Videoは4Kに対応していますか?
はい。画像からとテキストからの、どちらもフルモデルで対応しています。高速なturboの2つは720pと1080pです。4Kは1秒あたり1100コインなので、すでに手応えのあるカットに取っておくのが賢明です。
画像なしで、テキストだけから動画を作れますか?
作れます。画像から動画をつくる2つのモデルと並んで、テキストから動画をつくるモデルが2つあります。テキストは場面ごと発明し、画像はすでに決めた顔を保ちます。特定のキャラクターなら後者のほうがたいてい向いています。
終了フレームは何のためにありますか?
開始画像だけでなく終了画像も渡せて、モデルはその2枚のあいだの動きを組み立てます。気に入った静止画2枚が、動きの終点を当てずっぽうにせずひとつながりのカットになります。
クリップに音は付きますか?
任意で付きます。場面に合わせたサウンドトラックが生成されます。追加料金はかからず、自分で音を乗せるつもりならオフにできます。
続けて読む
音はもうできている: 音声編集のいらないAI動画
ふつうの制作には後半があります。書き出して、音楽を探して、効果音を探して、合わせて、また書き出す。その後半がありません。
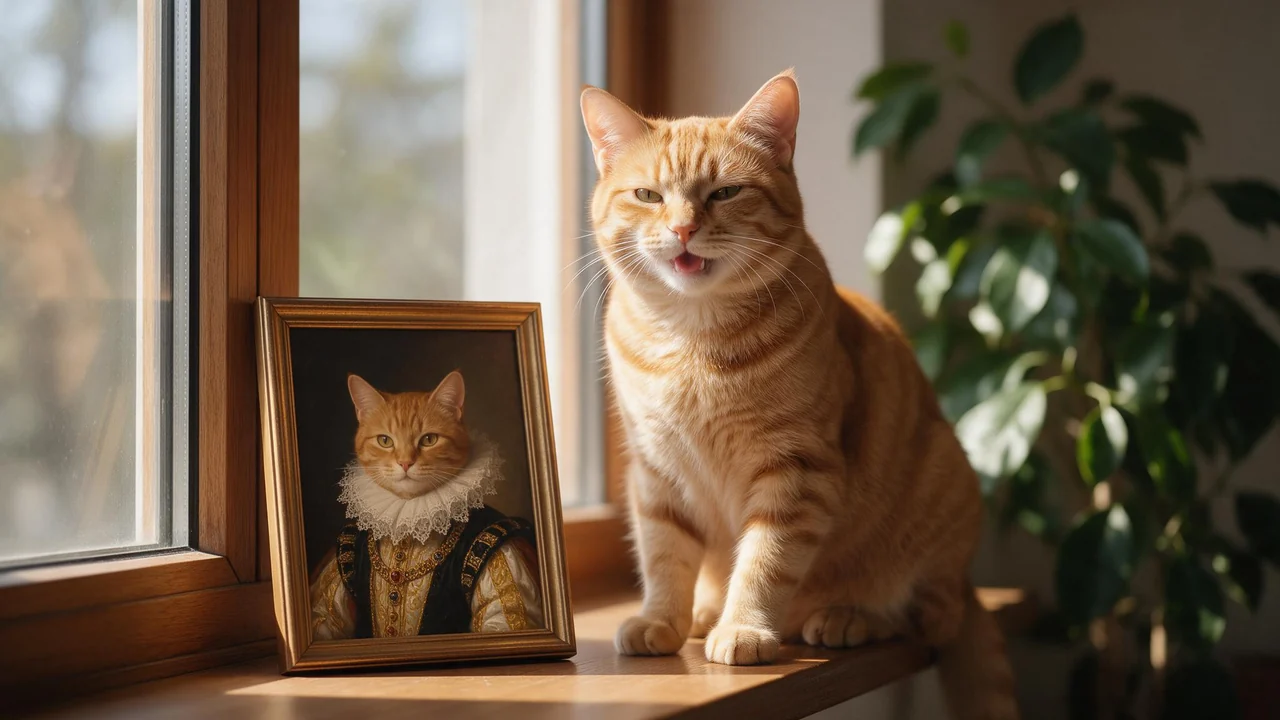
うちの子を名画に、騎士に、アニメの主人公に:自分の写真から作るAIペットポートレート
チューダー朝の女王になった茶トラ、宇宙服のビーグル、絵本の中のうさぎ。うちの子らしさを残したペットポートレートの小さなレシピと、ずれやすいところの正直なリストです。
テキストから動画か、画像から動画か: どちらを選ぶべきか
両方あり、置き換えは効きません。判断は単純です。特定の顔が最後まで残る必要があるなら、画像から始めてください。